# 【Python爬虫前传】我这算是这是爬虫技术吗?
# 一、背景
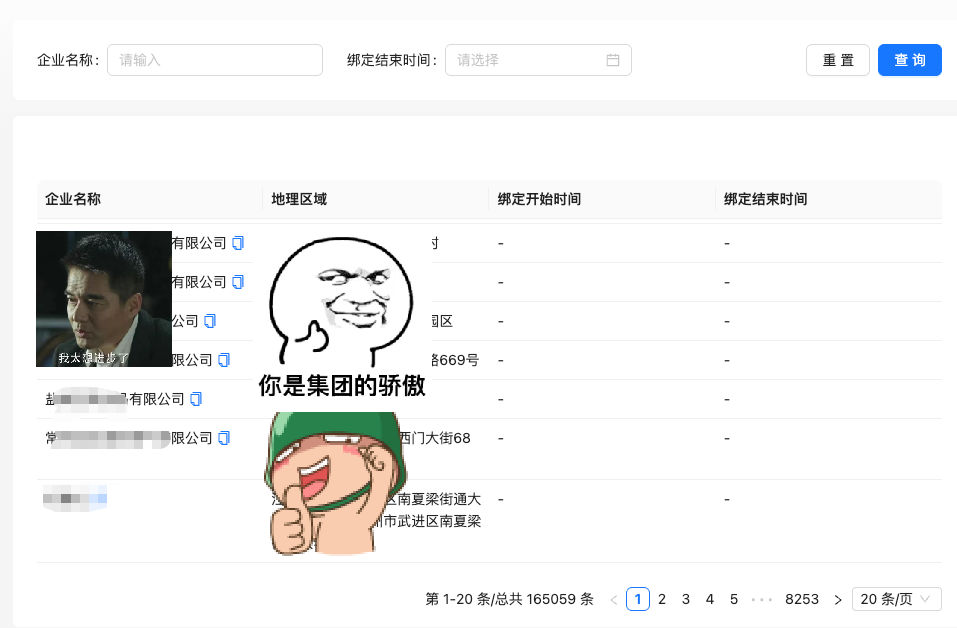
最近电力交易的同事在收集信息。遇到一个情况,页面里面有一个带分页的Table(信息已虚化)。里面的数据很多。查询起来很慢。他想保存到本地Excel。 但是页面里面没有提供下载功能。只能手动复制。 不仅慢,而且容易出错。主要你看一下页数。8253 多页面。🤦
# 二、准备工作
我调研了一些现有的工具和网上的方案。看看能不能快速完成任务。
- 浏览器插件
- RPA机器人
- Excel里面
- Python爬虫
- 交给AI skill(万金油)
总结:工具有很多、方案也不少。但是都有不少的学习成本。我作为一名前端出生的工程师。能不能用js解决问题呢?
# 三、方案
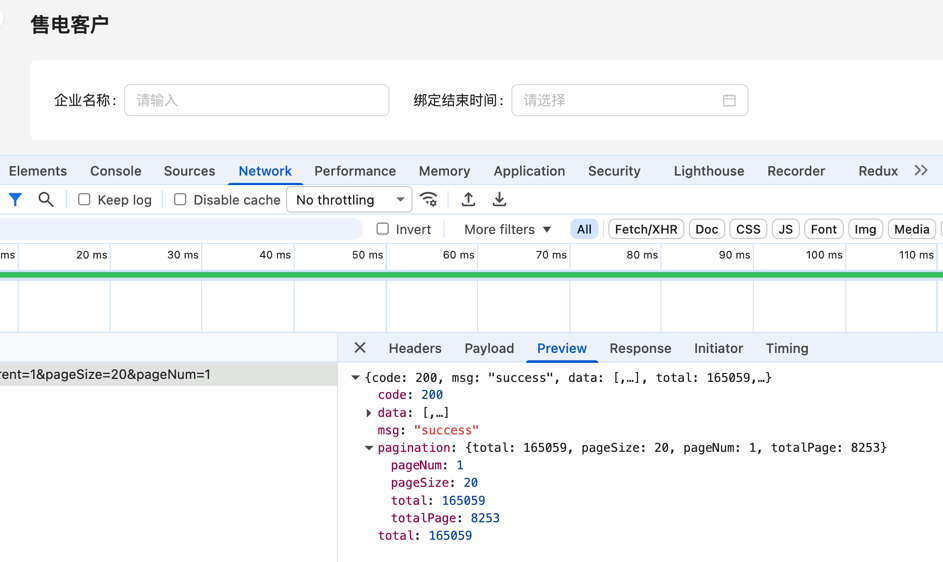
- 利用Fetch请求获取分页数据。拿到pageSize和pageIndex(current)。
- 手动计算出最大的 pageIndex。
- 打开调试模式,在控制台里面。手动JavaScript循环获取数据。
- 保存成JSON,并下载至本地。
- 利用Excel函数对JSON数据进行加工,导出Excel。
# 四、流程图
# 五、实现步骤
# 5.1 获取数据
如果没有totalPage。可以把 (total / pageSize) + 1
# 5.2 获取数据保存成json
(async () => {
  const url = "https://example.com/api/list";
  const totalPages = 2; // 就写上面计算的值。这里我用2代替了。初期验证可以写小一点。
  const pageSize = 20;  // 写个20应该没事。具体看页面的分页数据
  const allData = [];
  const sleep = ms => new Promise(r => setTimeout(r, ms)); // 防止请求过快,导致IP被封

  for (let page = 1; page <= totalPages; page++) {
    console.log(`正在请求第 ${page} 页`);
    try {
      const res = await fetch(`${url}?current=${page}&pageSize=${pageSize}`, {
        method: 'GET',
        credentials: 'include',
        headers: {
          "User-Agent": navigator.userAgent,
          "Accept": "application/json",
          "Referer": location.href
        }
      });

      if (!res.ok) {
        console.error(`第${page}页 HTTP 错误:${res.status}`);
        await sleep(5000);
        continue;
      }

      const json = await res.json();
      // 重点:这里用 list
      const list = json?.data?.list ?? [];
      allData.push(...list);
      console.log(`✅ 第 ${page} 页成功,本页${list.length}条,累计:${allData.length} 条`);

    } catch (err) {
      console.error(`❌ 第 ${page} 页失败:`, err);
    }
    await sleep(5000);
  }

  // 下载
  const blob = new Blob([JSON.stringify(allData, null, 2)], { type: 'application/json' }); // 为了格式化json文件
  const link = document.createElement('a');
  link.href = URL.createObjectURL(blob);
  link.download = 'all_data.json';
  link.click();
  console.log('🎉 抓取完成,文件已下载');
})();
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
保存json以后,可以使用Excel函数对数据进行加工,最后导出Excel。
const fs = require('fs');
const path = require('path');
const ExcelJS = require('exceljs');

/**
 * 读取本地json文件
 * @param {string} fileName 文件名/相对路径
 * @returns {Promise<Array>} json数组
 */
function getDataByLocal(fileName) {
  const dataPath = path.resolve(__dirname, fileName);
  return new Promise((resolve, reject) => {
    fs.readFile(dataPath, 'utf8', (err, content) => {
      if (err) {
        console.error('读取文件失败:', err);
        return reject(err);
      }
      try {
        const res = JSON.parse(content);
        resolve(res);
      } catch (parseErr) {
        console.error('JSON解析失败:', parseErr);
        reject(parseErr);
      }
    });
  });
}

/**
 * json导出xlsx
 * @param {string} [fileName='all_data.json'] 源json文件名
 * @param {string} [outFileName='output.xlsx'] 输出xlsx文件名
 * @returns {Promise<void>}
 */
async function exportJsonToXlsx(fileName = 'all_data.json', outFileName = 'output.xlsx') {
  try {
    const data = await getDataByLocal(fileName);

    // 校验是否为数组,防止forEach报错
    if (!Array.isArray(data)) {
      throw new Error('json数据必须是数组格式');
    }
    if (data.length === 0) {
      console.warn('警告:json数组为空,将生成空表格');
    }

    const workbook = new ExcelJS.Workbook();
    const worksheet = workbook.addWorksheet('sheet1');

    worksheet.columns = [
      { header: '企业名称', key: 'membersName', width: 30 },
      { header: '企业地址', key: 'regAddress', width: 80 },
      { header: '开始时间', key: 'startDate', width: 15 },
      { header: '结束时间', key: 'endDate', width: 15 },
    ];

    worksheet.addRows(data); // ✅ 优化:ExcelJS原生addRows,代替forEach循环addRow

    const outPath = path.resolve(__dirname, outFileName);
    await workbook.xlsx.writeFile(outPath);
    console.log(`✅ 导出成功,文件:${outPath}`);
  } catch (err) {
    console.error('❌ 导出异常:', err);
  }
}

// 使用示例
// exportJsonToXlsx();
// exportJsonToXlsx('./all_data.json');
exportJsonToXlsx('./all_data.json', '企业清单.xlsx');
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
# 六、相关链接
关注公众号
组队学习,一同成长 
扫码添加好友
备注 加群学习 
我的第二步 →